20 Ajuste de Modelos de Regresión Lineal Simple en R
En la siguiente clase, exploraremos cómo ajustar modelos de regresión lineal simple en R y cómo interpretar los resultados obtenidos. Un paso crucial en la regresión lineal simple es encontrar los coeficientes \(\beta_0\) y \(\beta_1\) que minimizan la diferencia entre los valores observados y los valores predichos por el modelo.
Ajuste del Modelo
En R, podemos ajustar un modelo de regresión lineal simple utilizando la función lm(). Tomemos el ejemplo de la base de datos “cars” que utilizamos anteriormente. Queremos ajustar un modelo que prediga la distancia de frenado (\(y\)) en función de la velocidad (\(x\)).
En este caso, estamos ajustando un modelo lineal donde la variable dependiente es “dist” (distancia de frenado) y la variable independiente es “speed” (velocidad).
Interpretación de Coeficientes
Una vez ajustado el modelo, podemos obtener información sobre los coeficientes \(\beta_0\) y \(\beta_1\) utilizando la función summary().
Call:
lm(formula = dist ~ speed, data = cars)

Residuals:
    Min      1Q  Median      3Q     Max
-29.069  -9.525  -2.272   9.215  43.201

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) -17.5791     6.7584  -2.601   0.0123 *
speed         3.9324     0.4155   9.464 1.49e-12 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 15.38 on 48 degrees of freedom
Multiple R-squared:  0.6511,    Adjusted R-squared:  0.6438
F-statistic: 89.57 on 1 and 48 DF,  p-value: 1.49e-12
El resultado proporciona detalles sobre los coeficientes estimados. En particular, estamos interesados en:
Estimate: Estimación de los coeficientes \(\beta_0\) y \(\beta_1\).
Std. Error: Error estándar de las estimaciones.
t value: Valor t, que mide cuántas desviaciones estándar está la estimación del coeficiente respecto a cero.
Pr(>|t|): Valor p, que nos indica si la estimación del coeficiente es estadísticamente significativa.
Gráfico de Ajuste
Un gráfico de ajuste nos ayuda a visualizar cómo la línea de regresión se ajusta a los datos observados. Podemos crear este gráfico utilizando la función geom_smooth().
require(ggplot2)
# Gráfico de ajuste
ggplot(cars, aes(x = speed, y = dist)) +
  geom_point() +
  geom_smooth(method = "lm", se = FALSE) +
  labs(title = "Ajuste del Modelo de Regresión Lineal",
       x = "Velocidad (mph)",
       y = "Distancia de Frenado (ft)")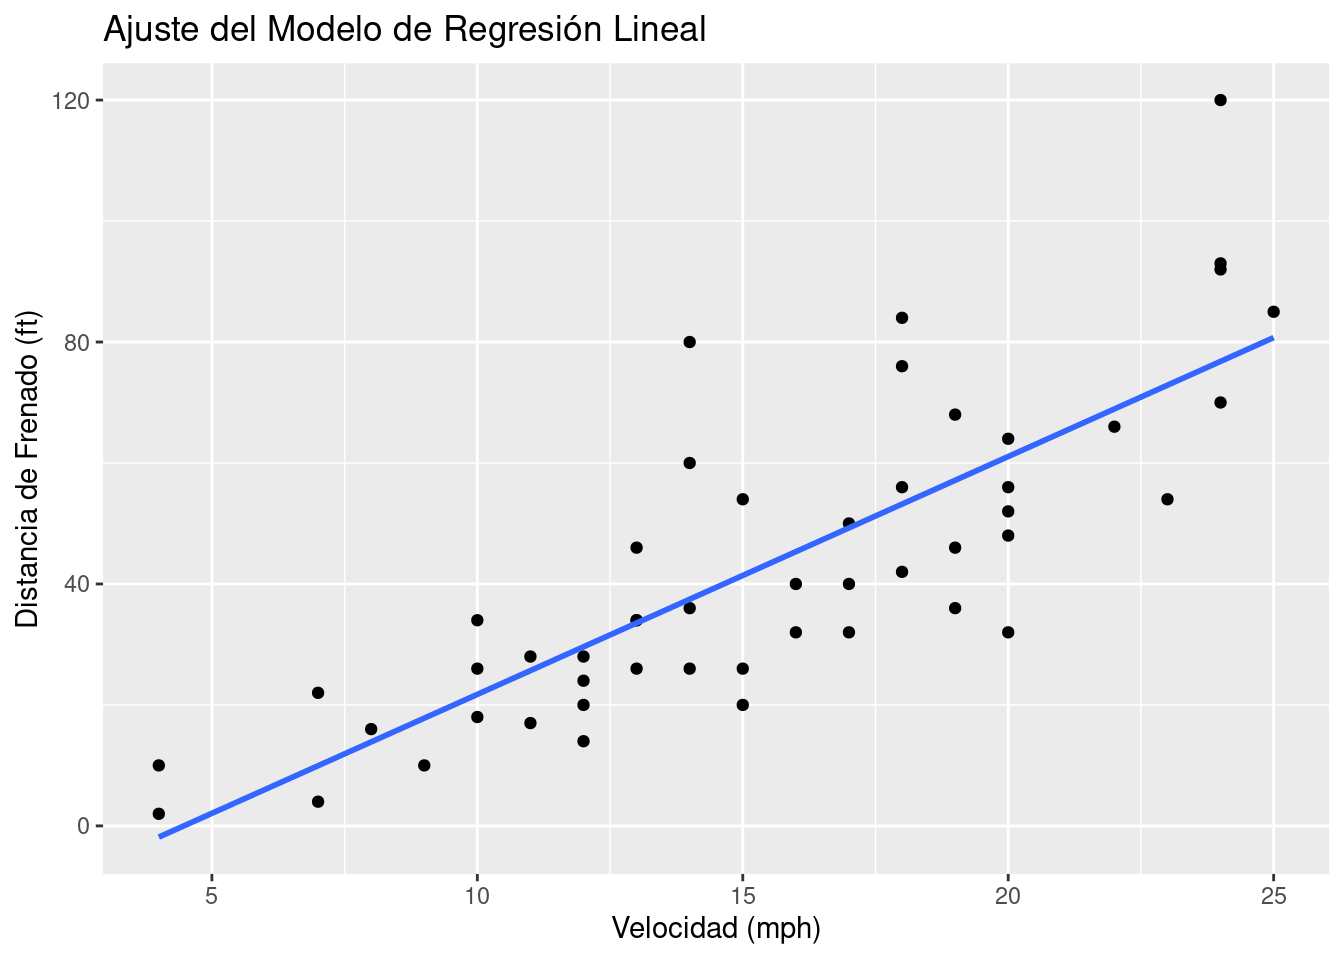
En el gráfico de ajuste, la línea representa la regresión lineal ajustada a los datos. Podemos observar cómo esta línea se ajusta a la tendencia general de los puntos.
Predicciones y Residuos
Otra parte importante del análisis de regresión lineal es hacer predicciones basadas en el modelo ajustado y evaluar los residuos (diferencias entre los valores observados y predichos).
# Realizar predicciones
predicciones <- predict(modelo, newdata = data.frame(speed = c(10, 20, 30)))
predicciones
1 2 3
21.74499 61.06908 100.39317 # Obtener residuos
residuos <- resid(modelo)
par(mfrow = c(1,2))
boxplot(residuos, main = "Distribución de los residuos",
col = "seagreen")
hist(residuos, main = "", col = "seagreen")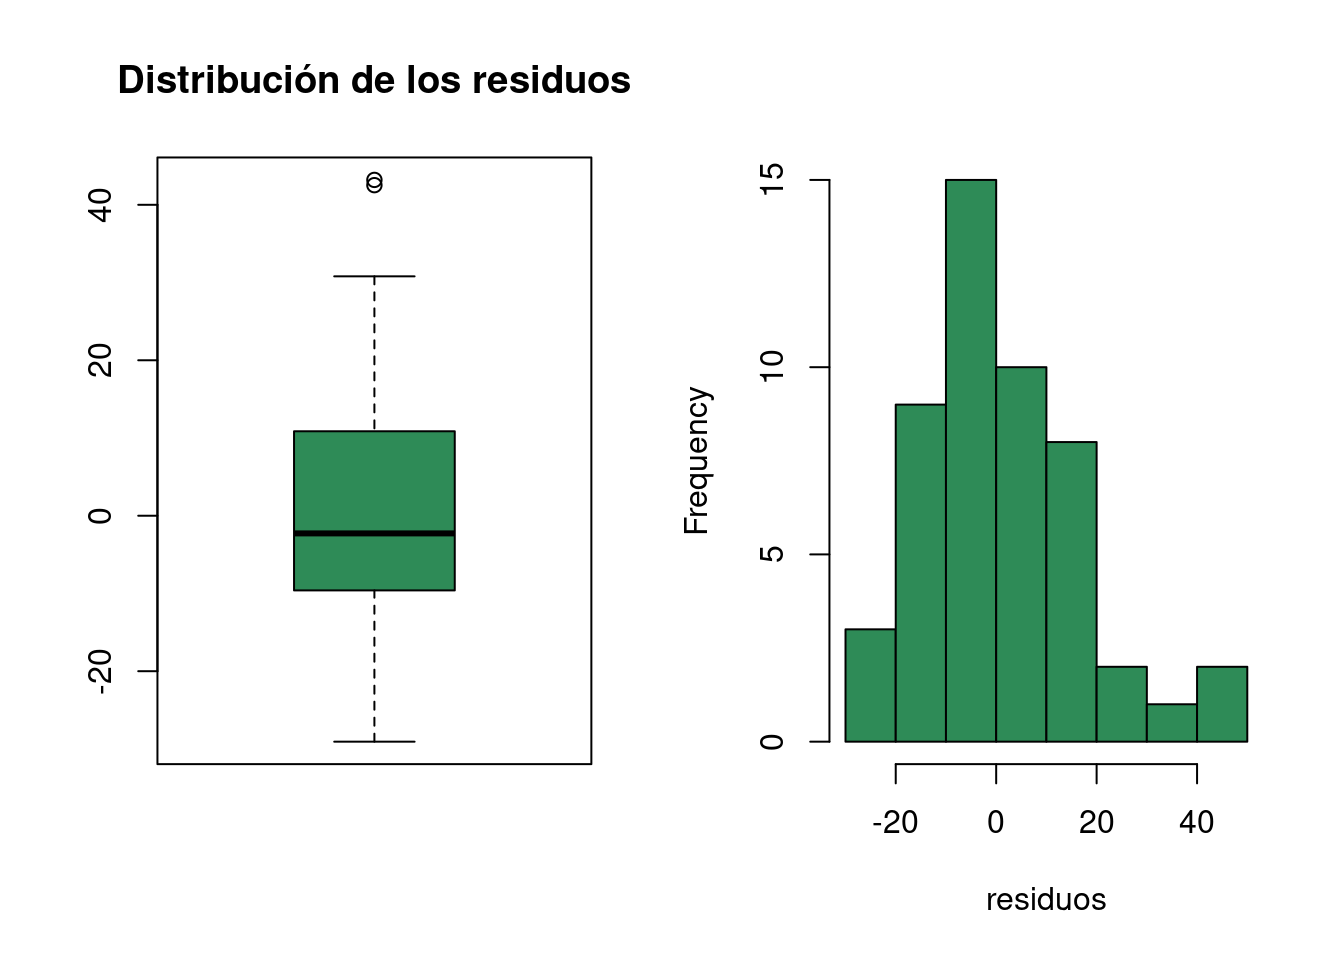
Las predicciones nos dan los valores predichos por el modelo para nuevos valores de la variable independiente. Los residuos nos dan una idea de cuánto se desvían los valores observados de los valores predichos.
En resumen, ajustar un modelo de regresión lineal simple en R implica usar la función lm(), interpretar los resultados con summary(), visualizar el ajuste con un gráfico y evaluar predicciones y residuos.
En la siguiente clase, exploraremos cómo interpretar y comunicar los resultados de la regresión lineal simple.
Ejercicios
Utiliza la base de datos “mtcars” que contiene información sobre diferentes modelos de automóviles. Ajusta un modelo de regresión lineal para predecir el consumo de combustible por galón (\(mpg\)) en función del número de cilindros (\(cyl\)). Interpreta los resultados y crea un gráfico de ajuste.
# Ajuste del modelo de regresión lineal con mtcars
modelo_mtcars <- lm(mpg ~ cyl, data = mtcars)
summary(modelo_mtcars)
Call:
lm(formula = mpg ~ cyl, data = mtcars)

Residuals:
    Min      1Q  Median      3Q     Max
-4.9814 -2.1185  0.2217  1.0717  7.5186

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  37.8846     2.0738   18.27  < 2e-16 ***
cyl          -2.8758     0.3224   -8.92 6.11e-10 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 3.206 on 30 degrees of freedom
Multiple R-squared:  0.7262,    Adjusted R-squared:  0.7171
F-statistic: 79.56 on 1 and 30 DF,  p-value: 6.113e-10
# Gráfico de ajuste
ggplot(mtcars, aes(x = cyl, y = mpg)) +
geom_point() +
geom_smooth(method = "lm", se = FALSE) +
labs(title = "Ajuste del Modelo de Regresión Lineal - mtcars",
x = "Número de Cilindros",
y = "Consumo de Combustible (mpg)")`geom_smooth()` using formula = 'y ~ x'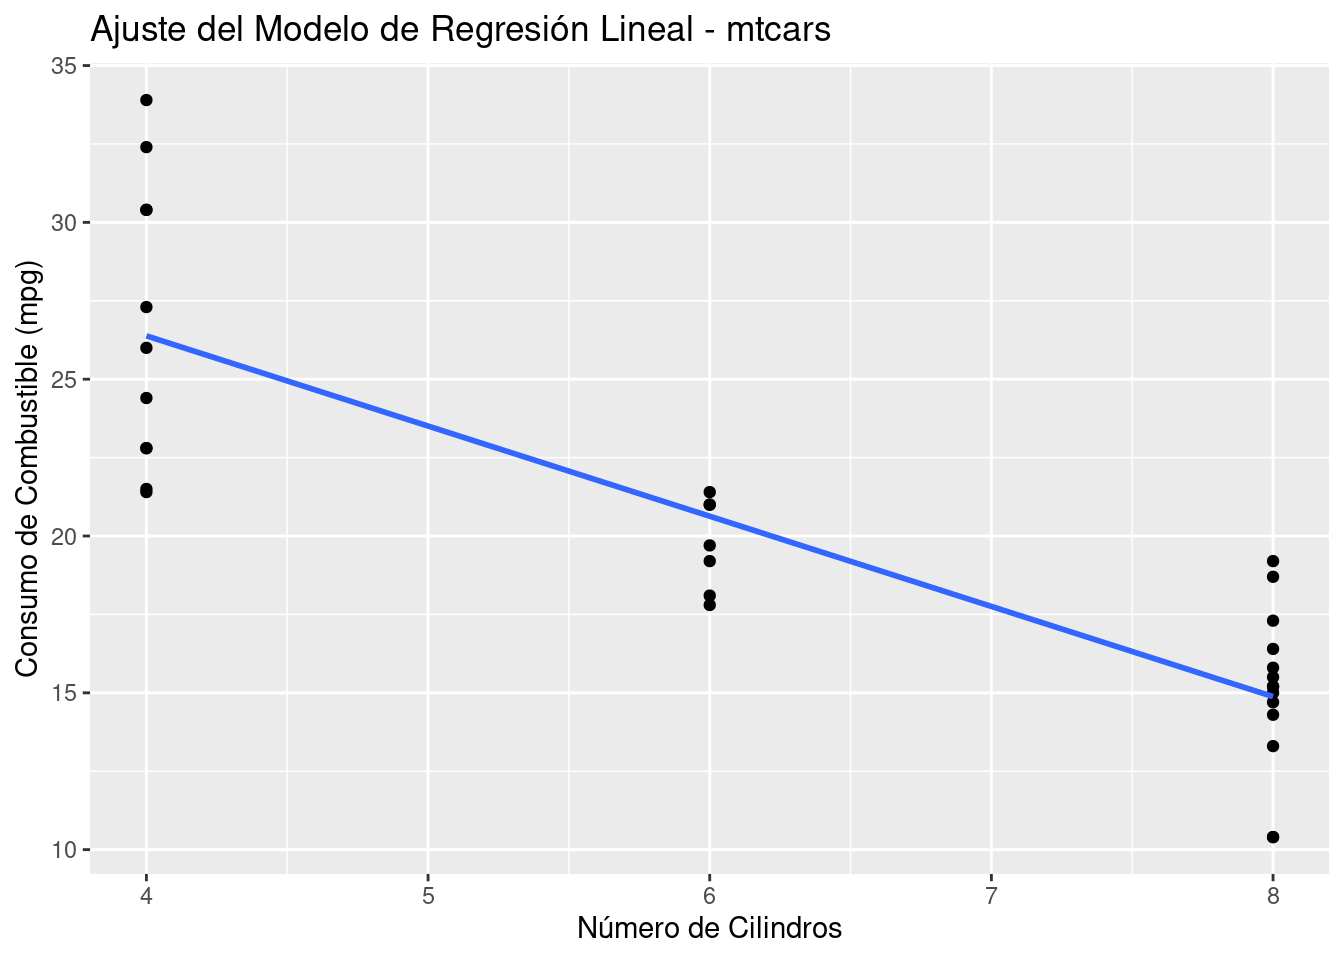
Utiliza la base de datos “iris” que contiene información sobre diferentes especies de flores iris. Ajusta un modelo de regresión lineal para predecir la longitud del sépalo (\(Sepal.Length\)) en función del ancho del sépalo (\(Sepal.Width\)). Interpreta los resultados y evalúa las predicciones del modelo.
# Ajuste del modelo de regresión lineal con iris
modelo_iris <- lm(Sepal.Length ~ Sepal.Width, data = iris)
summary(modelo_iris)
Call:
lm(formula = Sepal.Length ~ Sepal.Width, data = iris)

Residuals:
    Min      1Q  Median      3Q     Max
-1.5561 -0.6333 -0.1120  0.5579  2.2226

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   6.5262     0.4789   13.63   <2e-16 ***
Sepal.Width  -0.2234     0.1551   -1.44    0.152
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 0.8251 on 148 degrees of freedom
Multiple R-squared:  0.01382,   Adjusted R-squared:  0.007159
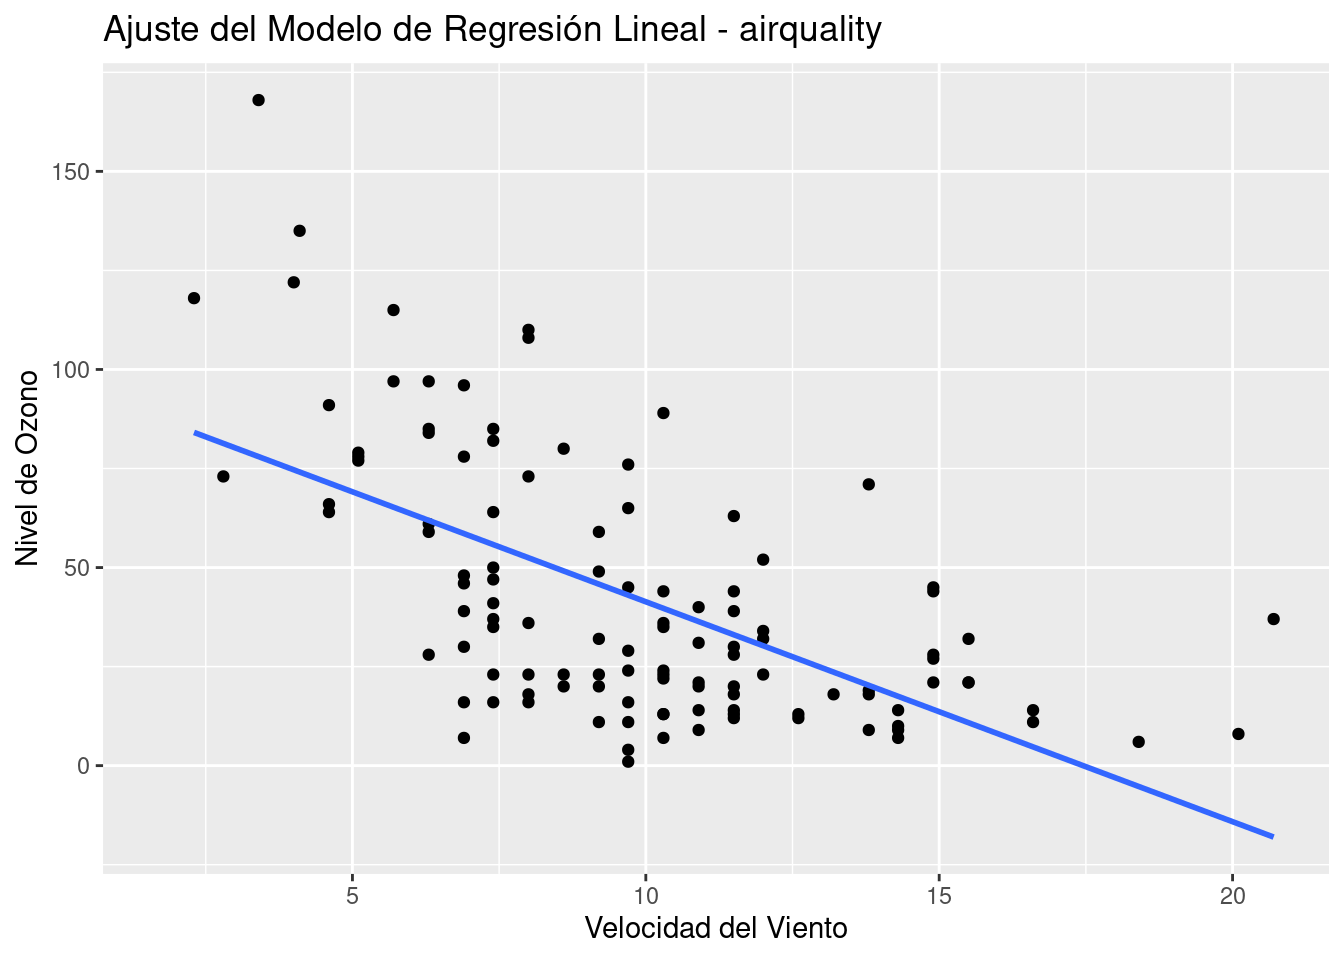
F-statistic: 2.074 on 1 and 148 DF, p-value: 0.1519Utiliza la base de datos “airquality” que contiene información sobre la calidad del aire en Nueva York. Ajusta un modelo de regresión lineal para predecir el nivel de ozono (\(Ozone\)) en función de la velocidad del viento (\(Wind\)). Analiza los coeficientes estimados y crea un gráfico de ajuste.
# Ajuste del modelo de regresión lineal con airquality
modelo_airquality <- lm(Ozone ~ Wind, data = airquality)
summary(modelo_airquality)
Call:
lm(formula = Ozone ~ Wind, data = airquality)

Residuals:
    Min      1Q  Median      3Q     Max
-51.572 -18.854  -4.868  15.234  90.000

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  96.8729     7.2387   13.38  < 2e-16 ***
Wind         -5.5509     0.6904   -8.04 9.27e-13 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 26.47 on 114 degrees of freedom
  (37 observations deleted due to missingness)
Multiple R-squared:  0.3619,    Adjusted R-squared:  0.3563
F-statistic: 64.64 on 1 and 114 DF,  p-value: 9.272e-13
# Gráfico de ajuste
ggplot(airquality, aes(x = Wind, y = Ozone)) +
geom_point() +
geom_smooth(method = "lm", se = FALSE) +
labs(title = "Ajuste del Modelo de Regresión Lineal - airquality",
x = "Velocidad del Viento",
y = "Nivel de Ozono")`geom_smooth()` using formula = 'y ~ x'Warning: Removed 37 rows containing non-finite values (`stat_smooth()`).Warning: Removed 37 rows containing missing values (`geom_point()`).