# Cargar la base de datos
data("mtcars")

# Ajustar el modelo de regresión lineal
modelo <- lm(mpg ~ wt, data = mtcars)

# Gráficos de residuos
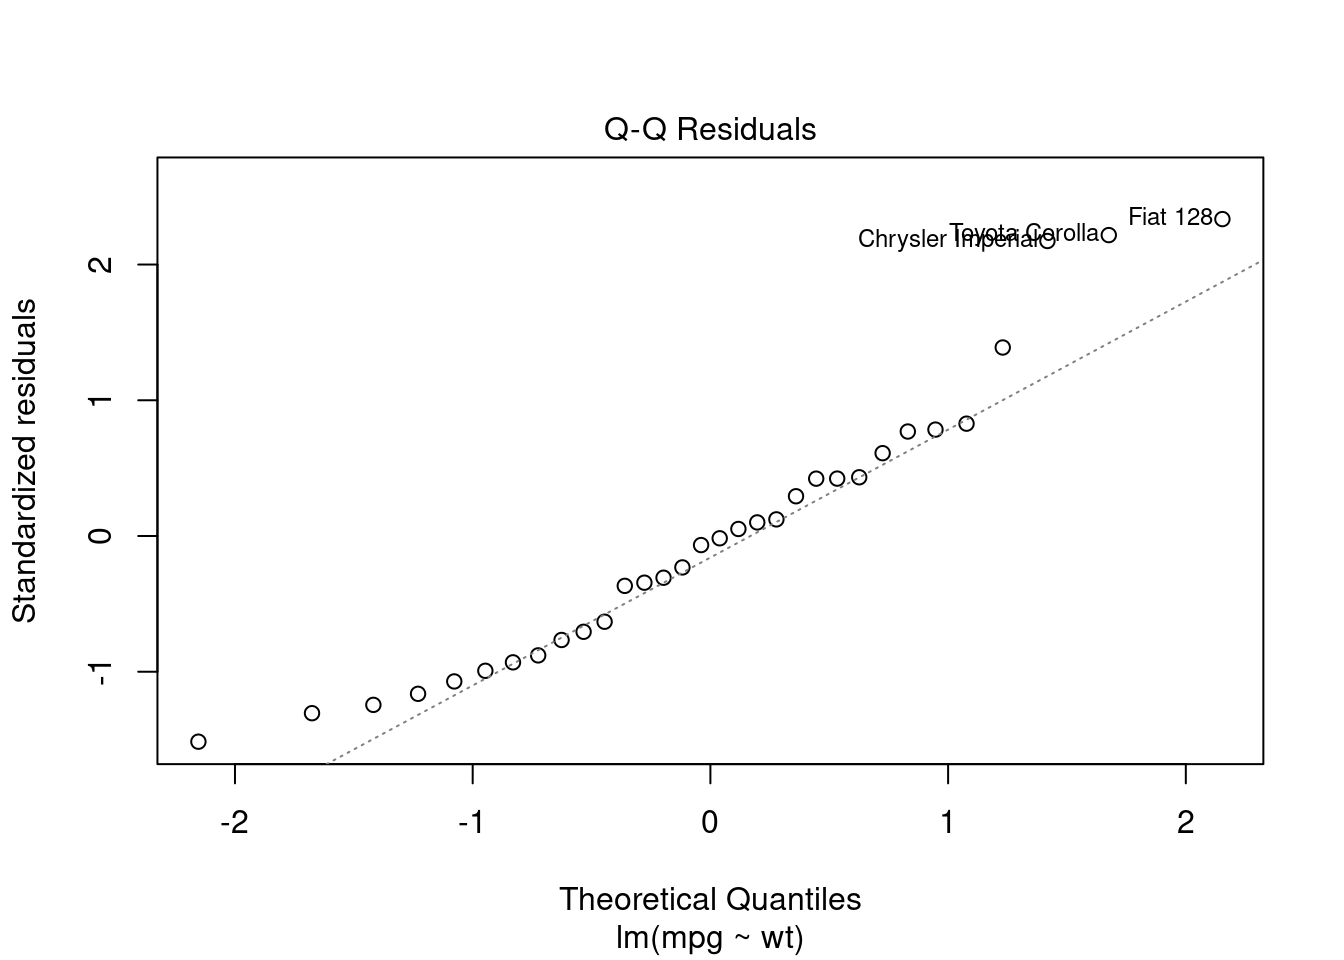
plot(modelo, which = 1)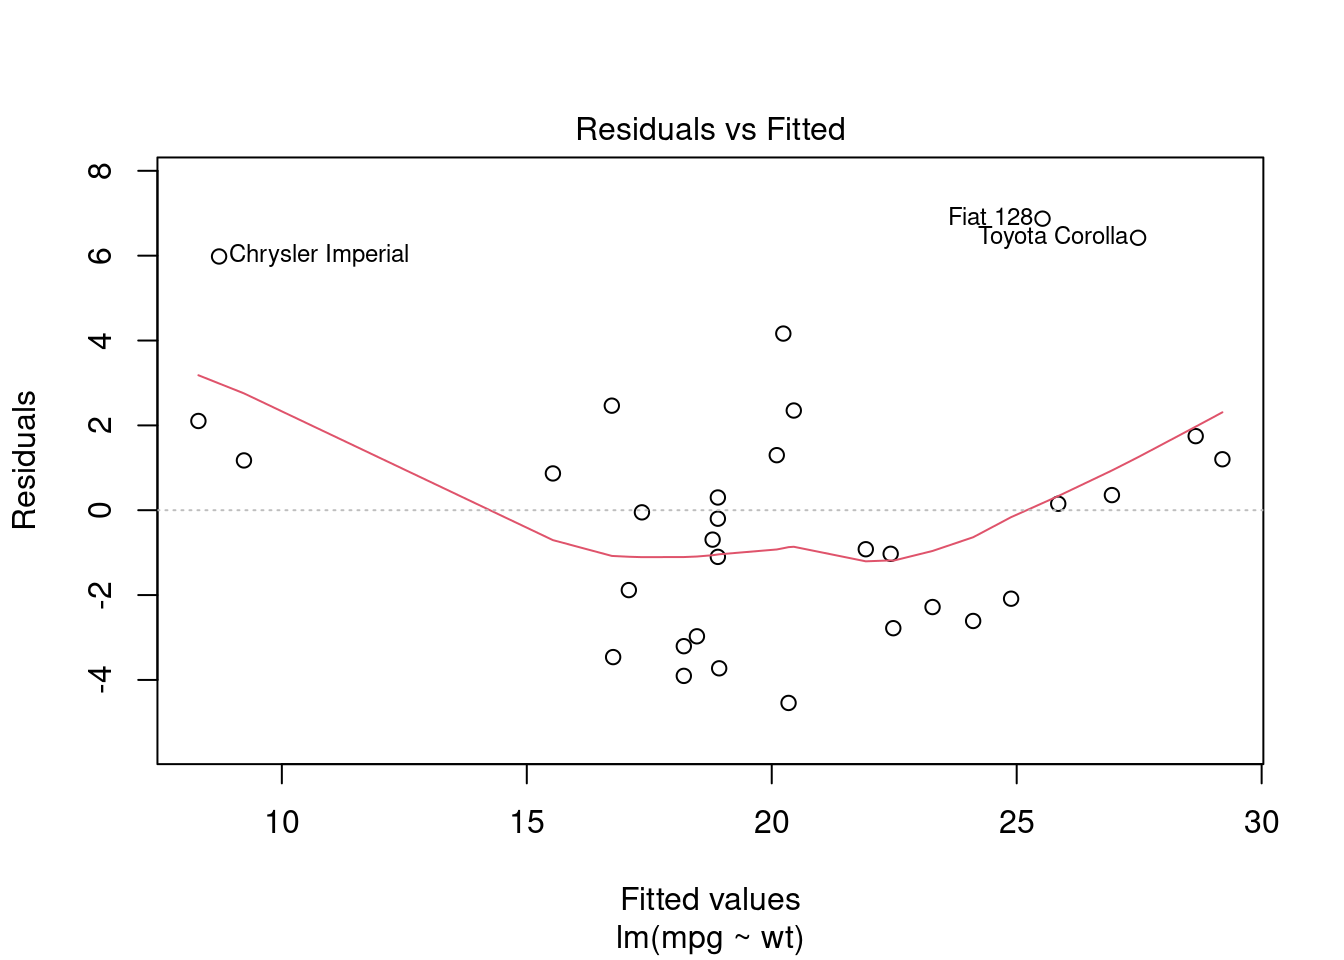
En esta clase, nos sumergiremos en la interpretación y comunicación de los resultados obtenidos a partir de un modelo de regresión lineal simple. Una vez que hemos ajustado el modelo y obtenido los coeficientes, es crucial comprender cómo estos coeficientes afectan la relación entre las variables y cómo podemos comunicar eficazmente los hallazgos a otros.
Los coeficientes del modelo de regresión lineal simple tienen significados específicos que nos ayudan a comprender la relación entre las variables involucradas.
El coeficiente \(\beta_0\) (también conocido como el término de intersección) representa el valor estimado de la variable dependiente cuando la variable independiente es igual a cero. Sin embargo, esta interpretación puede no ser relevante en todos los contextos.
El coeficiente \(\beta_1\) (el coeficiente de la variable independiente) indica cómo cambia la variable dependiente por un cambio unitario en la variable independiente. Esta es una interpretación clave y nos dice cómo se relacionan las dos variables.
Una parte crítica de la interpretación de los resultados de la regresión lineal simple es evaluar la calidad del ajuste del modelo y verificar si se cumplen los supuestos subyacentes. A continuación, profundizaremos en algunas pruebas y conceptos clave para realizar estas evaluaciones.
Uno de los supuestos fundamentales de la regresión lineal es que los errores (residuos) del modelo deben ser distribuidos normalmente y tener varianza constante. Podemos evaluar estos supuestos mediante gráficos de residuos y pruebas estadísticas.
Gráficos de Residuos: Los gráficos de residuos nos permiten visualizar si los residuos siguen un patrón particular. Por ejemplo, un gráfico de residuos vs. valores ajustados puede revelar si los residuos tienen varianza constante a lo largo de los valores ajustados.
Prueba de Normalidad: Pruebas estadísticas como el test de Shapiro-Wilk o el test de Anderson-Darling se utilizan para evaluar si los residuos siguen una distribución normal.
Prueba de Varianza Constante: La prueba de Breusch-Pagan o la prueba de White se utilizan para verificar si la varianza de los residuos es constante a lo largo de los valores ajustados.
Otro supuesto clave es la linealidad de la relación entre las variables independiente y dependiente. Además, debemos verificar si hay colinealidad entre las variables independientes.
Gráficos de Residuos vs. Variables Independientes: Estos gráficos pueden ayudar a identificar patrones no lineales en la relación entre las variables.
VIF (Factor de Inflación de la Varianza): El VIF se utiliza para detectar colinealidad entre las variables independientes. Valores altos de VIF indican alta correlación entre variables.
La heteroscedasticidad ocurre cuando la varianza de los residuos cambia a lo largo de los valores ajustados.
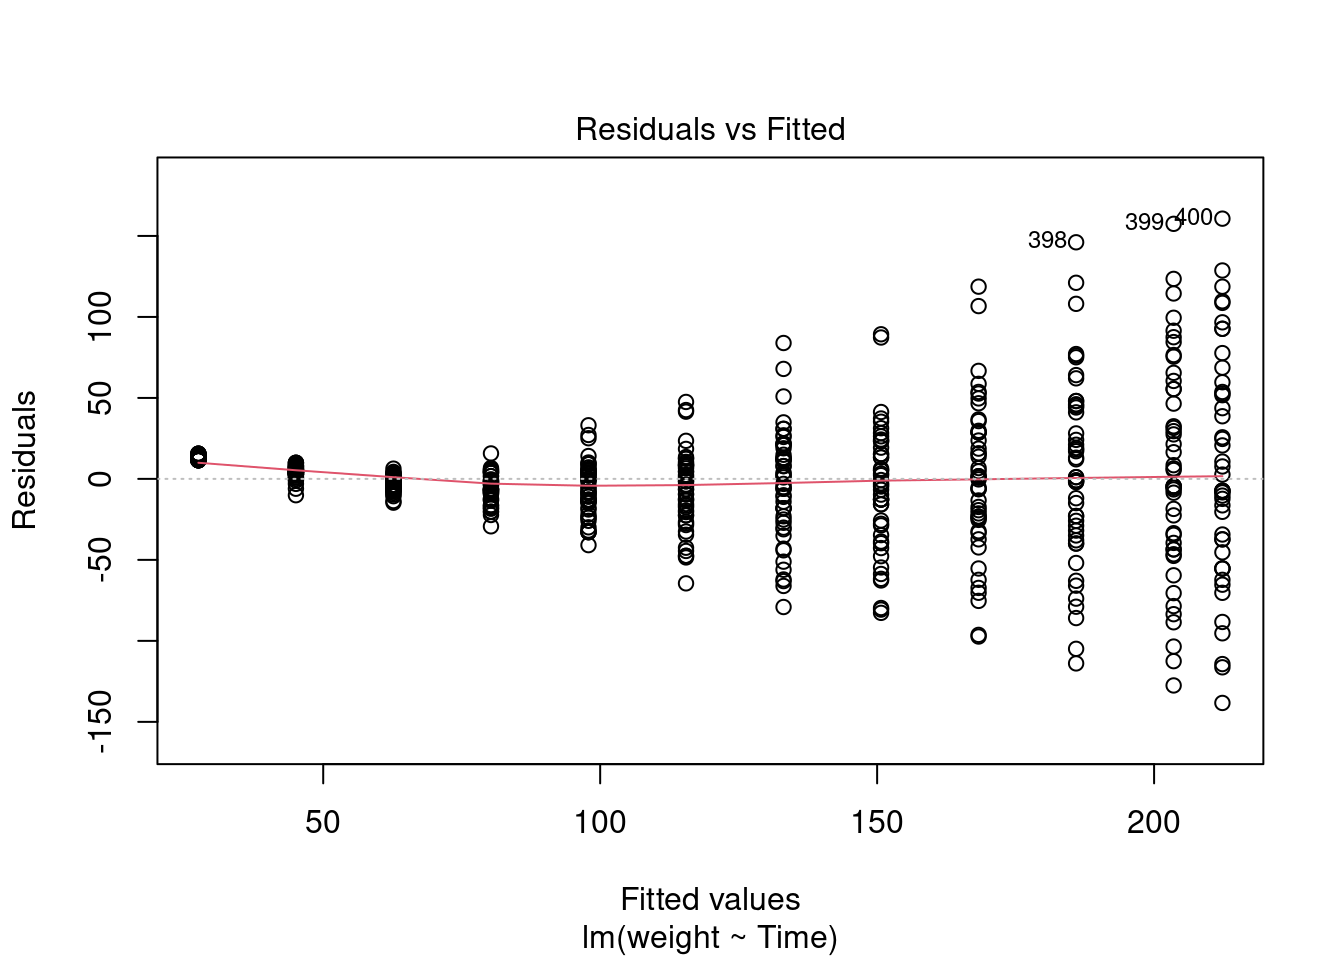
Gráficos de Residuos vs. Valores Ajustados: Los patrones con forma de embudo en estos gráficos pueden indicar heteroscedasticidad.
Prueba de Breusch-Pagan: Esta prueba estadística se utiliza para evaluar la presencia de heteroscedasticidad.
La comunicación efectiva de los resultados es fundamental para compartir los hallazgos con otros y tomar decisiones informadas. Aquí hay algunas pautas clave:
Utiliza términos simples y evita jerga técnica tanto como sea posible.
Proporciona contextos y explicaciones claras para los resultados.
Utiliza gráficos y visualizaciones para respaldar tus explicaciones.
Menciona las limitaciones y supuestos del modelo para una presentación precisa.
Recuerda que la interpretación y comunicación de los resultados son pasos esenciales en el proceso de análisis de regresión lineal simple. Estos pasos garantizan que no solo comprendas los resultados, sino que también puedas transmitir su significado de manera efectiva a otros.
Usa la base de datos mtcars. Ajusta un modelo de regresión lineal simple donde la variable dependiente sea el consumo de gasolina (mpg) y la variable independiente sea el peso (wt). Luego, realiza gráficos de residuos y pruebas de normalidad y varianza constante en los residuos para evaluar los supuestos del modelo.
# Cargar la base de datos
data("mtcars")
# Ajustar el modelo de regresión lineal
modelo <- lm(mpg ~ wt, data = mtcars)
# Gráficos de residuos
plot(modelo, which = 1)
# Libreria que almacena diferentes test
# para evaluar la regresión
library(lmtest)

# Prueba de normalidad (Shapiro-Wilk)
shapiro.test(modelo$residuals)
    Shapiro-Wilk normality test

data:  modelo$residuals
W = 0.94508, p-value = 0.1044
    studentized Breusch-Pagan test

data:  modelo
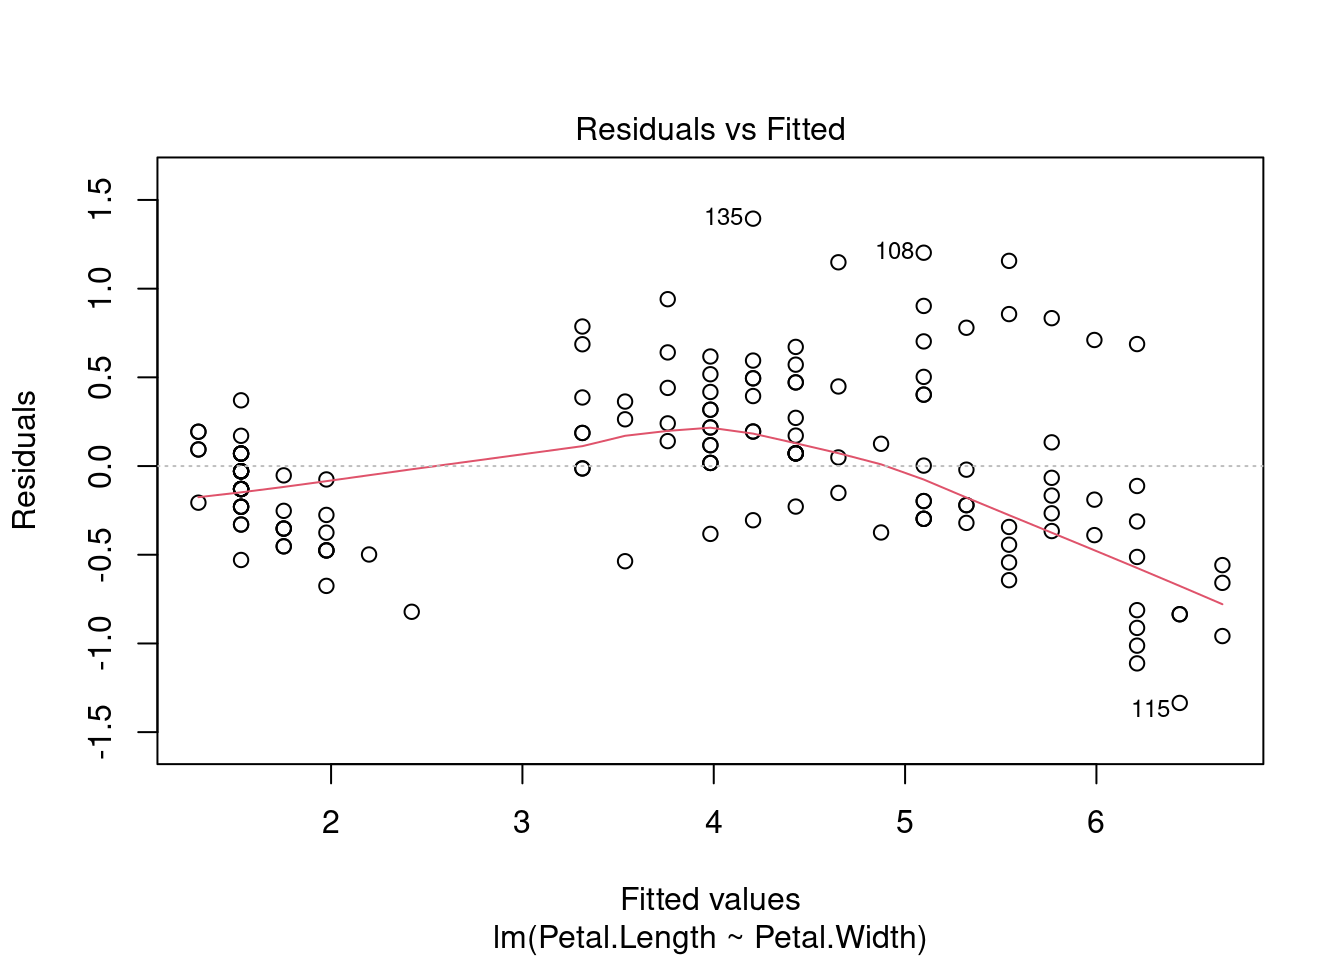
BP = 0.040438, df = 1, p-value = 0.8406Usa la base de datos iris. Ajusta un modelo de regresión lineal simple donde la variable dependiente sea la longitud del pétalo (Petal.Length) y la variable independiente sea el ancho del pétalo (Petal.Width). Realiza gráficos de residuos vs. variables independientes y calcula los VIF para verificar la linealidad y colinealidad.
Usa la base de datos ChickWeight. Ajusta un modelo de regresión lineal simple donde la variable dependiente sea el peso del pollo (weight) y la variable independiente sea el tiempo (Time). Realiza un gráfico de residuos vs. valores ajustados y realiza la prueba de Breusch-Pagan para identificar la presencia de heteroscedasticidad.
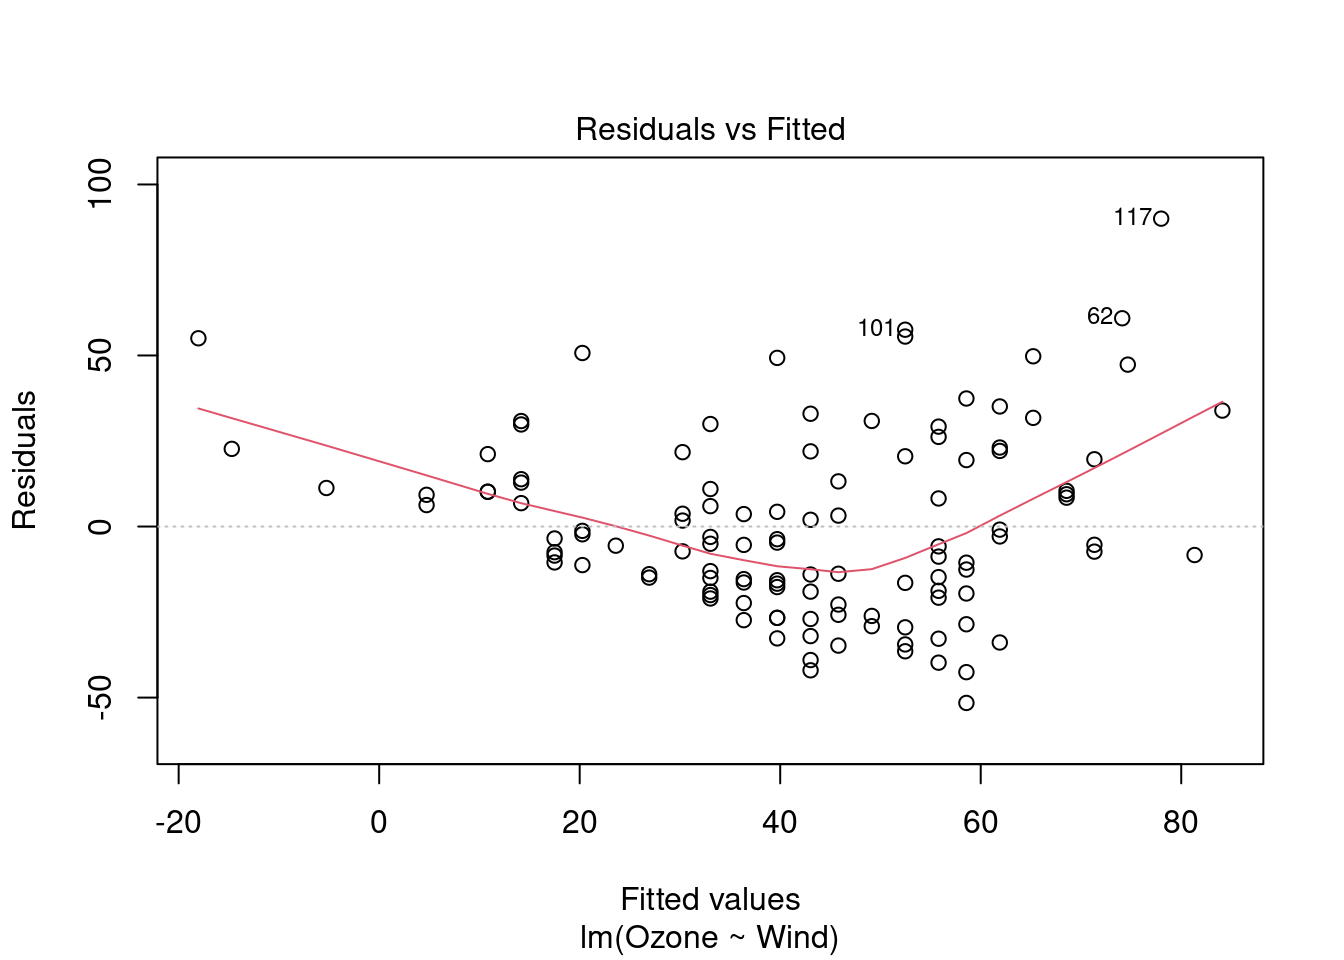
Usa la base de datos airquality. Ajusta un modelo de regresión lineal simple donde la variable dependiente sea la concentración de ozono (Ozone) y la variable independiente sea la velocidad del viento (Wind). Realiza una evaluación completa del modelo, incluyendo gráficos de residuos, pruebas de normalidad, varianza constante, linealidad y colinealidad.
# Cargar la base de datos
data("airquality")

# Ajustar el modelo de regresión lineal
modelo <- lm(Ozone ~ Wind, data = airquality)

# Gráficos de residuos
par(mfrow = c(2, 2))
plot(modelo)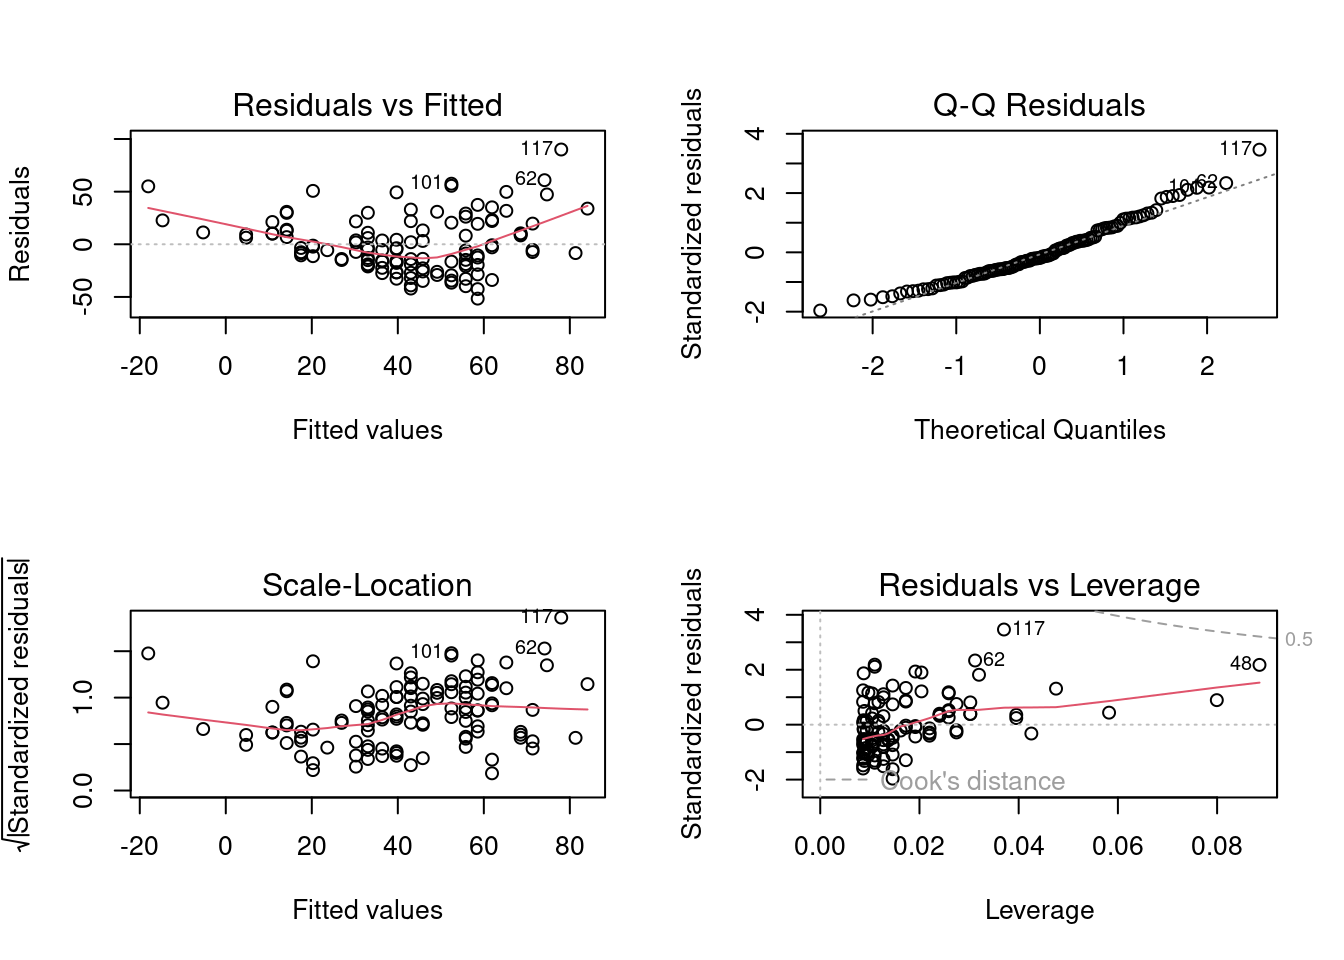
    Shapiro-Wilk normality test

data:  modelo$residuals
W = 0.9673, p-value = 0.006214
    studentized Breusch-Pagan test

data:  modelo
BP = 7.5642, df = 1, p-value = 0.005954